


La paradoja de Simpson

Los mismos datos pueden defender conclusiones opuestas; el problema no está en la aritmética, sino en qué estamos preguntando.
En 1986, cuatro investigadores publicaron en The British Medical Journal una comparación de distintos tratamientos para cálculos renales.
Dos de ellos permiten plantear un problema aparentemente sencillo.
De 350 pacientes sometidos a cirugía abierta, 273 tuvieron un tratamiento exitoso:

es decir, una tasa de éxito del 78 %.
Otros 350 pacientes fueron tratados mediante nefrolitotomía percutánea.
En este grupo hubo 289 éxitos:

aproximadamente 83 %.
Si hubiera que decidir únicamente con esos números, la respuesta parece evidente: el segundo procedimiento obtiene mejores resultados.
Pero falta una variable, el tamaño de los cálculos renales.
Cuando los investigadores separaron los casos según esa característica, ocurrió algo bastante incómodo.
Para cálculos pequeños, la cirugía abierta había conseguido:

mientras que la nefrolitotomía percutánea alcanzaba:

La cirugía abierta presentaba una tasa de éxito mayor.
Para cálculos grandes:

frente a:

Otra vez, la cirugía abierta presentaba una tasa de éxito mayor.
El procedimiento que perdía en el resultado general ganaba en cada uno de los dos grupos.
No cambiaron los pacientes. No desaparecieron observaciones. No hubo que corregir ningún cálculo.
Los mismos datos acababan de cambiar de dirección.

El problema está escondido en los pesos
Para entender qué ocurrió no hace falta comenzar con una paradoja. Basta observar cómo se construye una proporción total.
La tasa global de éxito de la cirugía abierta puede escribirse como:

Donde:

La expresión es una aplicación de la ley de la probabilidad total.
Dice algo aparentemente inocente: la tasa global es un promedio ponderado de las tasas de cada subgrupo.
Para la cirugía abierta:

La mayor parte de los pacientes operados mediante cirugía abierta tenía cálculos grandes: 263 de 350.
Ahora hagamos lo mismo con la nefrolitotomía percutánea:

Aquí ocurre exactamente lo contrario: 270 de los 350 pacientes tenían cálculos pequeños.
Y los cálculos pequeños eran, en general, más fáciles de tratar con éxito.
Ahí está la trampa.
No estamos comparando dos promedios construidos con los mismos pesos.
La nefrolitotomía recibe muchísimo peso del grupo con mejor pronóstico; la cirugía abierta, del grupo con peor pronóstico.
Por eso es perfectamente posible que:

y también:

pero al mismo tiempo:

No existe contradicción matemática.
Existe una diferencia en la composición de las poblaciones que estamos promediando.
Eso es el corazón de la paradoja de Simpson.
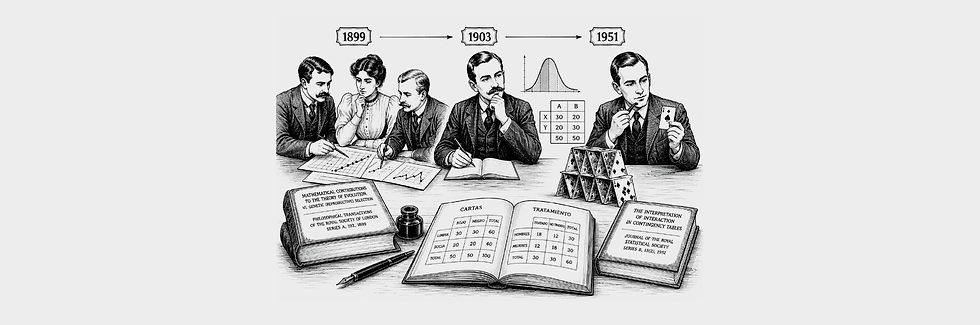
Una paradoja anterior a Simpson
El nombre puede engañar.
Edward Hugh Simpson no fue el primero en observar este fenómeno.
En 1899, Karl Pearson, Alice Lee y Leslie Bramley-Moore ya habían advertido que al combinar grupos heterogéneos podían aparecer correlaciones que no estaban presentes dentro de los grupos originales.
Cuatro años después, George Udny Yule dedicó parte de un trabajo publicado en Biometrika a los problemas que podían surgir al mezclar registros procedentes de poblaciones diferentes.
La preocupación ya estaba ahí: una asociación observada después de reunir datos podía no representar la relación existente dentro de las poblaciones que habían sido reunidas.
Simpson llevó el problema a otro punto en 1951.
Su artículo se titulaba The Interpretation of Interaction in Contingency Tables y estudiaba tablas 2 x 2 x 2
Su objetivo no era presentar una curiosidad estadística, sino cuestionar cuándo era legítimo colapsar una tabla eliminando una de sus variables.
Construyó primero un ejemplo con una baraja. Clasificó las cartas por color, tipo y por una característica adicional: algunas estaban sucias porque habían sido manipuladas por un bebé.
Después hizo algo mucho más interesante.
Conservó esencialmente las mismas probabilidades y cambió el significado de las variables: ahora representaban hombres y mujeres, personas tratadas y no tratadas, supervivientes y fallecidos.
La aritmética era la misma.
La interpretación razonable ya no lo era.
En el ejemplo de las cartas, combinar categorías podía tener sentido. En el médico, Simpson señalaba que sería difícil rechazar como inútil un tratamiento que mostraba beneficio tanto entre hombres como entre mujeres simplemente porque ese beneficio desapareciera en la población agregada.
La tabla no había cambiado.
Había cambiado lo que las variables significaban en el mundo.
Eso convierte su artículo en algo más profundo que una demostración sobre porcentajes.
Simpson estaba mostrando que los números, por sí solos, podían no decirnos qué comparación debía importarnos.
Curiosamente, tampoco fue él quien bautizó el fenómeno.
El término “Simpson's paradox” apareció en 1972 en un artículo de Colin R. Blyth, quien además relacionó el problema con el sure-thing principle de la teoría de decisiones.
Una paradoja que no descubrió primero Simpson y que tampoco llamó Simpson. Las matemáticas tienen cierto talento para los epónimos mal acomodados.

Qué dice realmente la paradoja
Consideremos tres variables:

Una forma fuerte de la paradoja aparece cuando, para cada valor de Z,

pero después de combinar todos los grupos:

La dirección de la asociación se invierte.
También existen versiones en las que una asociación aparece o desaparece al agregar los datos. Por eso la literatura contemporánea trata la paradoja de Simpson como una familia de fenómenos relacionados con la agregación y la desagregación, no exclusivamente como una inversión estricta.
La mecánica puede verse mediante:


determina cuánto pesa cada subgrupo en el resultado agregado.
Si esos pesos son distintos para los valores de X, los promedios resultantes también pueden serlo.
Por eso saber que una alternativa gana dentro de cada categoría no basta, en general, para concluir que ganará después de mezclar categorías con proporciones diferentes.
La intuición falla porque solemos imaginar un promedio de promedios como si todos estuvieran construidos sobre la misma población.
No necesariamente lo están.

Cuándo la inversión deja de ser posible
El mecanismo anterior también revela una condición importante.
Supongamos que la distribución de Z fuese idéntica en los dos grupos:

Entonces ambos resultados agregados utilizarían los mismos pesos.
Para la diferencia usual entre tasas de éxito,

esa ventaja no puede invertirse simplemente al agregarlos con ponderaciones idénticas.
La literatura especializada desarrolla esta idea formalmente: si ambos grupos reciben las mismas ponderaciones sobre Z, desaparece el mecanismo que permite esta inversión estándar de las proporciones.
Esto explica también por qué el diseño experimental importa.
Una asignación aleatoria bien realizada tiende precisamente a equilibrar las características previas entre grupos. No garantiza mágicamente que desaparezca cualquier fenómeno relacionado con no colapsabilidad, pero sí elimina una de las condiciones que producen muchas de las inversiones que solemos asociar con Simpson.

Entonces, ¿cuál resultado debemos creer?
Aquí comienza la parte realmente difícil.
Una respuesta muy difundida consiste en decir: hay que desagregar los datos.
Suena razonable. También es falso como regla general.
Imagine una variable Z que causa tanto la exposición X como el resultado Y:

Z puede actuar como variable de confusión.
Si queremos estimar el efecto de X sobre Y, comparar sujetos con valores similares de Z puede ser necesario para evitar atribuir a X diferencias que en realidad proceden de Z.
Ese es el tipo de razonamiento que parece operar en el ejemplo de los cálculos renales: el tamaño del cálculo está relacionado tanto con la selección del tratamiento como con la probabilidad de éxito.
Pero ahora cambiemos el esquema. Supongamos:

Aquí Z es un mediador: forma parte del camino mediante el cual X afecta a Y.
Si nuestro objetivo es estimar el efecto total de X, controlar Z puede eliminar precisamente una parte del efecto que queremos medir.
Hay una tercera posibilidad:

Ahora Z es un collider, una consecuencia común de X y Y.
Condicionar por él puede generar una asociación entre X y Y que no existía previamente.
Tres diagramas muy parecidos. Tres decisiones estadísticas diferentes.
Por eso Miguel Hernán, David Clayton y Niels Keiding insistieron en 2011 en que el problema de Simpson no puede resolverse eliminando el contexto causal y tratando únicamente las asociaciones estadísticas.
Los datos pueden decirnos qué asociaciones existen.
No siempre pueden decirnos por sí solos qué variable debemos controlar.

Asociación no es intervención
Esta diferencia puede expresarse con dos cantidades que parecen similares pero responden preguntas distintas.
La primera es:

Significa:
¿Qué probabilidad de Y observamos entre las personas para las que X = x?
Es una distribución observacional.
La inferencia causal quiere responder algo diferente:

La notación

popularizada en el marco de modelos causales de Judea Pearl, representa una intervención: fijar X en el valor x y preguntar cómo cambiaría Y.
La diferencia es pequeña en símbolos y enorme en significado. Encontrar que:

no demuestra automáticamente que intervenir sobre X incremente Y.
Puede existir confusión, selección, mediación u otra estructura causal detrás de la asociación observada.
La paradoja de Simpson resulta especialmente valiosa porque vuelve visible ese problema. Nos obliga a preguntar qué proceso produjo las proporciones que estamos comparando.

Berkeley y el peligro de aprender una moraleja demasiado simple
Uno de los casos más famosos asociados con Simpson ocurrió en la Universidad de California, Berkeley.
En 1973, los datos agregados de admisiones de posgrado parecían mostrar una fuerte desventaja para las mujeres.
Entre los solicitantes de los seis departamentos más grandes que posteriormente se popularizaron como conjunto de datos, aproximadamente el 44.5 % de los hombres fueron admitidos frente al 30.4 % de las mujeres.
La lectura inmediata parecía evidente: discriminación en contra de las solicitantes.
Peter Bickel, Eugene Hammel y John O'Connell analizaron el problema y publicaron sus resultados en Science en 1975.
Al examinar las unidades de decisión por separado encontraron una historia muy distinta. Las mujeres tendían a solicitar ingreso en departamentos con tasas de admisión menores para ambos sexos. Una parte importante de la diferencia agregada provenía, por tanto, de qué departamentos recibían las solicitudes, no de una tendencia uniforme de los departamentos a rechazar mujeres.
Pero aquí también conviene resistirse a una moraleja fácil.
El trabajo original no decía simplemente: “los datos agregados estaban equivocados y los desagregados tenían razón”.
Los autores discutían mecanismos institucionales y sociales anteriores a la decisión departamental: la distribución de solicitudes tampoco surgía en el vacío.
Eso introduce una pregunta más interesante.
Si una desigualdad desaparece después de controlar una variable, ¿hemos eliminado un sesgo o hemos condicionado por una variable que forma parte del mecanismo mediante el cual surge la desigualdad?
La respuesta ya no pertenece exclusivamente a la aritmética.
Depende de la pregunta causal.

Lo que Simpson no demuestra
La paradoja ha producido algunas moralejas bastante cómodas y bastante malas.
Una es: “Las estadísticas pueden demostrar cualquier cosa.”
No. En todos los ejemplos anteriores, las operaciones matemáticas son correctas. El problema aparece cuando confundimos cantidades que describen poblaciones diferentes o les atribuimos interpretaciones que no se desprenden de los datos.
Otra es: “Los datos agregados mienten.” Tampoco.
Una estadística agregada puede ser exactamente la cantidad que necesitamos para responder ciertas preguntas. Si una empresa quiere conocer su tasa total de conversión, esa tasa es una cantidad legítima. Si quiere determinar qué versión de una campaña funciona mejor controlando diferencias entre públicos, quizá necesite otra comparación.
No existe un mandato estadístico universal que diga “agrega” o “desagrega”.
Existe una pregunta previa: ¿qué queremos estimar?
Una tercera simplificación afirma que Simpson es únicamente una consecuencia de variables de confusión.
Muchos ejemplos importantes sí involucran confusión, pero la literatura distingue este problema de otros relacionados con la colapsabilidad de las medidas de asociación. Incluso medidas habituales como el odds ratio pueden cambiar al ajustar por variables sin que ese cambio equivalga necesariamente a eliminar confusión.
Conviene, por tanto, no utilizar “paradoja de Simpson”, “confusión” y “no colapsabilidad” como si fueran tres nombres del mismo fenómeno. No lo son.

Una paradoja sin contradicción
La sensación de imposibilidad que produce Simpson nace de una intuición razonable.
Si una opción es mejor en el grupo 1 y también en el grupo 2, esperamos que siga siendo mejor cuando juntamos los grupos.
Esa conclusión sería válida si estuviéramos combinando las comparaciones con pesos equivalentes.
Pero los datos agregados no tienen esa obligación.
Dos tasas globales son dos promedios ponderados y sus pesos pueden ser radicalmente distintos.
En el caso renal, la cirugía abierta cargaba con una proporción mucho mayor de casos difíciles. La nefrolitotomía percutánea recibía mucho más peso de los casos pequeños.
Los porcentajes globales no ignoraron esa diferencia.
La incorporaron.
Precisamente por eso cambiaron.
La paradoja desaparece matemáticamente en cuanto vemos los pesos.
Pero entonces aparece una pregunta más seria: ¿debemos comparar los resultados agregados o los condicionados?
El trabajo de Simpson mostró que unas mismas relaciones numéricas podían requerir interpretaciones distintas dependiendo de qué representaran realmente las variables.
La inferencia causal moderna llevó esa observación más lejos: para decidir qué comparación representa un efecto, necesitamos información sobre cómo se relacionan las variables, no solamente una tabla con frecuencias.
Y ahí está la idea que hace que esta paradoja siga importando.

Los datos no contienen la pregunta
Una tabla puede estar perfectamente calculada y aun así ser insuficiente.
Puede contener todas las observaciones, todas las proporciones y todos los totales correctos, pero ninguna columna indica automáticamente qué variable es causa, cuál es consecuencia, cuál produjo selección o cuál debería mantenerse fija.
Eso debemos aportarlo nosotros mediante diseño, conocimiento del problema y supuestos causales que puedan defenderse.
La paradoja de Simpson no demuestra que los datos sean poco fiables.
Demuestra algo más incómodo: la corrección de un cálculo no garantiza la corrección de una interpretación.
Agregar puede ocultar una relación. Desagregar puede revelarla.
Y, en otras circunstancias, desagregar puede fabricar precisamente la relación que intentábamos comprender.
Los números hacen exactamente lo que deben. La responsabilidad difícil empieza después.
Fuentes consultadas
Pearson, Karl; Lee, Alice; Bramley-Moore, Leslie. Mathematical Contributions to the Theory of Evolution. VI. Genetic (Reproductive) Selection: Inheritance of Fertility in Man, and of Fecundity in Thoroughbred Racehorses. Philosophical Transactions of the Royal Society of London. Series A, vol. 192, 1899, pp. 257–330.
Yule, George Udny. Notes on the Theory of Association of Attributes in Statistics. Biometrika, vol. 2, núm. 2, 1903, pp. 121–134.
Simpson, E. H. The Interpretation of Interaction in Contingency Tables. Journal of the Royal Statistical Society. Series B, vol. 13, núm. 2, 1951, pp. 238–241.
Blyth, Colin R. On Simpson's Paradox and the Sure-Thing Principle. Journal of the American Statistical Association, vol. 67, núm. 338, 1972, pp. 364–366.
https://www.tandfonline.com/doi/abs/10.1080/01621459.1972.10482387
Bickel, Peter J.; Hammel, Eugene A.; O'Connell, J. W. Sex Bias in Graduate Admissions: Data from Berkeley. Science, vol. 187, núm. 4175, 1975, pp. 398–404.
Charig, C. R.; Webb, D. R.; Payne, S. R.; Wickham, J. E. Comparison of Treatment of Renal Calculi by Open Surgery, Percutaneous Nephrolithotomy, and Extracorporeal Shockwave Lithotripsy. British Medical Journal, vol. 292, núm. 6524, 1986, pp. 879–882.
Hernán, Miguel A.; Clayton, David; Keiding, Niels. The Simpson's Paradox Unraveled. International Journal of Epidemiology, vol. 40, núm. 3, 2011, pp. 780–785.
Sprenger, Jan; Weinberger, Naftali. Simpson's Paradox. Stanford Encyclopedia of Philosophy. Primera publicación: 2021; revisión sustantiva: 6 de junio de 2026.


Comentarios